С 24 по 29 октября 2026 года в Будапеште прошла конференция EMNLP 2026 (Conference on Empirical Methods in Natural Language Processing) — одно из ведущих международных научных мероприятий в области обработки естественного языка. На конференции была представлена работа «Multi-Model Framework for Sentiment Annotation: A Use Case of Multilingual Wikipedia». В статье описан метод автоматической разметки тональности текста, основанный на согласованности оценок нескольких моделей искусственного интеллекта и направленный на повышение надёжности получаемых результатов.
Традиционная ручная разметка текстовых данных требует значительных затрат времени и ресурсов, поэтому для решения этой задачи всё чаще используются большие языковые модели (LLM). Однако их оценки не всегда стабильны — один и тот же текст может получать разные метки в зависимости от используемой модели или повторного запуска анализа. Чтобы решить эту проблему, авторы предложили подход, в котором три языковые модели (GPT-5.2, Gemini 3.1 Pro и Claude Opus 4.6) выступают в роли независимых аннотаторов. Каждая из них трижды оценивала тональность одних и тех же предложений, классифицируя её как положительную, нейтральную или отрицательную, с возможностью отдельно отмечать случаи, не поддающиеся однозначной классификации. Метки считались особенно надёжными только в том случае, если все девять оценок совпадали. Метод был протестирован на предложениях из вводных разделов статей Википедии на пяти языках: английском, немецком, испанском, польском и русском. Выбор Википедии не был случайным — её статьи должны соответствовать принципу нейтральной точки зрения, что делает выявление тонких различий в тональности текста интересной исследовательской задачей.
Результаты показали, что полное совпадение всех девяти оценок наблюдалось для 71-76 % проанализированных предложений в зависимости от языка. Коэффициент каппа Флейсса, измеряющий степень согласованности оценок аннотаторов с учётом случайных совпадений, составил от 0,72 до 0,76, что свидетельствует о высоком уровне согласованности. Кроме того, оценки моделей сравнили с оценками людей на отдельных выборках предложений на польском и английском языках. Для предложений, отвечавших строгому критерию единогласия моделей, было достигнуто полное совпадение с оценками людей. Этот результат подтверждает перспективность предложенного подхода, хотя и не означает, что модели безошибочны во всех ситуациях. Исследование также выявило важное ограничение: отдельные модели заметно хуже справлялись с распознаванием отрицательной тональности, особенно в текстах преимущественно нейтрального характера.
Ещё одним важным результатом исследования стал многоязычный набор данных, содержащий более 75 тысяч предложений с присвоенными метками тональности и информацией о степени согласованности оценок моделей. Набор данных опубликован в открытом доступе на платформе Hugging Face и может использоваться в дальнейших исследованиях в области автоматического анализа текстов. Предложенный подход показывает, как совместное использование нескольких языковых моделей может способствовать созданию крупных размеченных наборов данных, повышая воспроизводимость и надёжность процесса разметки.
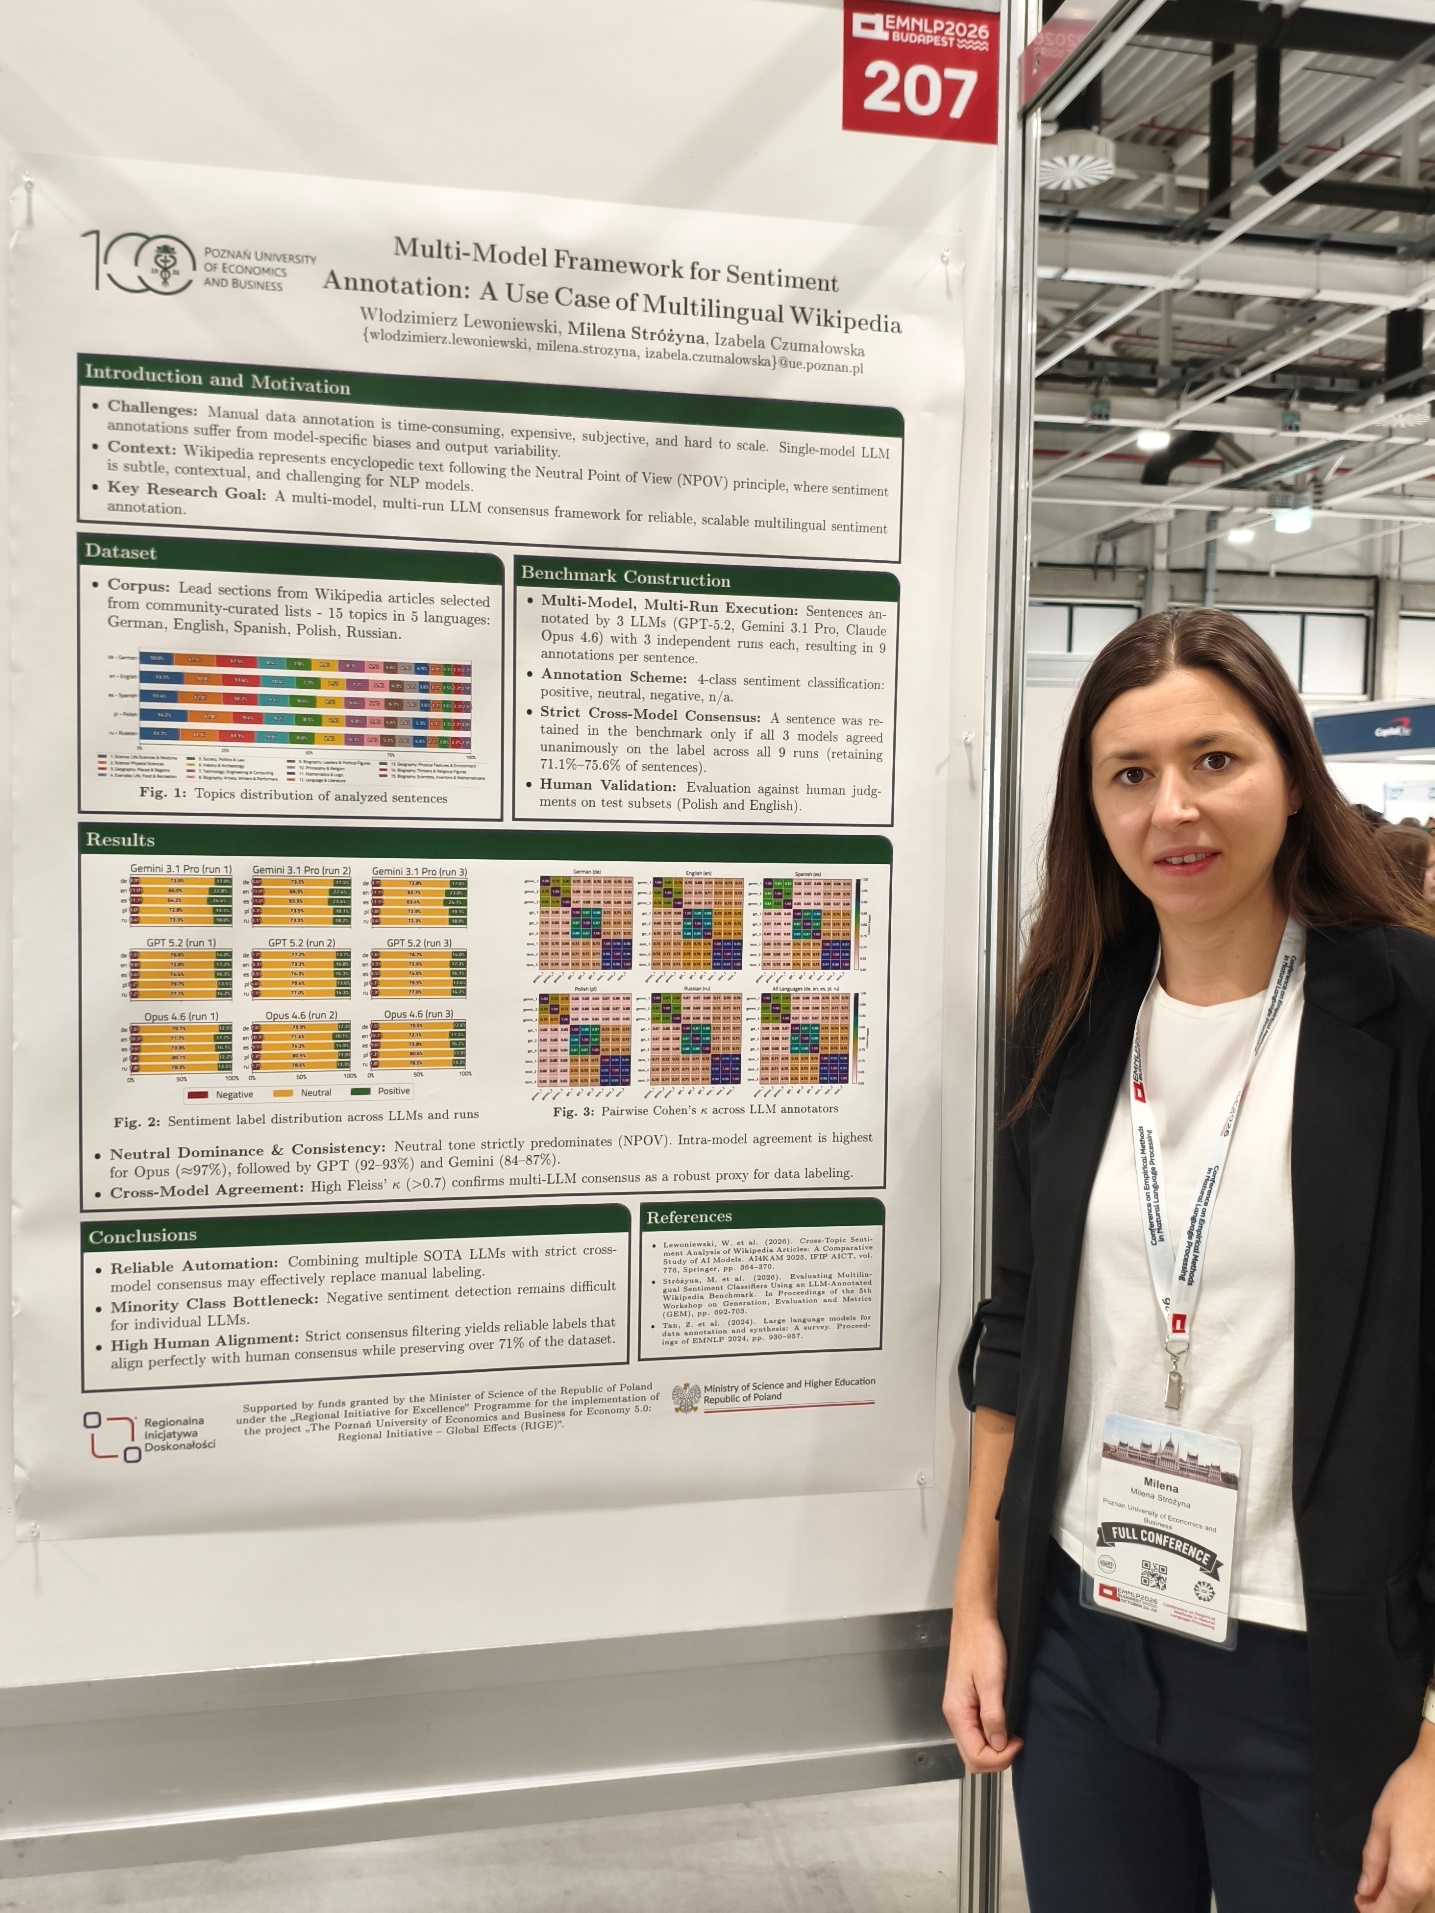
Авторы публикации — Владимир Левоневский, Милена Стружина и Изабела Чумаловская. Статья опубликована в сборнике научных трудов «Findings of the Association for Computational Linguistics: EMNLP 2026». Полный текст доступен в электронной научной библиотеке ACL Anthology. DOI: 10.18653/2026.findings-emnlp.1830
EMNLP — ежегодная конференция, организуемая SIGDAT, специализированной тематической группой Ассоциации компьютерной лингвистики (Association for Computational Linguistics, ACL). Она входит в число наиболее престижных научных конференций в области обработки естественного языка и имеет высшую категорию A* в рейтинге CORE. Конференция 2026 года проходила в выставочно-конгрессном центре HUNGEXPO в Будапеште.